Bộ câu hỏi kiểm tra trợ lý AI trên dữ liệu doanh nghiệp: xây thế nào, chấm ra sao
Bộ câu hỏi kiểm tra trợ lý AI trên dữ liệu doanh nghiệp: chọn câu hỏi, đáp án từ chứng từ, câu vượt quyền, cách chấm điểm và chạy lại khi đổi mô hình.
Tóm tắt nhanh
- Bộ câu hỏi kiểm tra (eval set) là danh sách câu hỏi thật của doanh nghiệp, mỗi câu kèm đáp án đúng lấy từ chứng từ, dùng để chấm trợ lý AI trước khi giao cho người dùng.
- Nên có năm nhóm câu: tra cứu một con số, tổng hợp và so sánh, truy vết qua nhiều chứng từ, câu vượt quyền (phải từ chối) và câu không có dữ liệu (phải nói không biết).
- Chấm theo bốn tiêu chí: đúng con số, có căn cứ từ dữ liệu, đúng phạm vi quyền, đúng trọng tâm câu hỏi. Câu nào chấm tự động được bằng so số thì chấm tự động.
- Chạy lại toàn bộ bộ câu hỏi mỗi khi đổi mô hình AI, thêm công cụ, sửa danh mục hay đổi phân quyền; so điểm với lần trước trước khi cho người dùng dùng tiếp.
Bộ câu hỏi kiểm tra trợ lý AI (eval set) là danh sách câu hỏi thật của doanh nghiệp, mỗi câu kèm đáp án đúng lấy từ chứng từ, dùng để chấm trợ lý AI trước khi giao cho người dùng và mỗi lần đổi mô hình, công cụ hay dữ liệu. Không có bộ câu hỏi này, "trợ lý trả lời có đúng không" chỉ là cảm giác của người dùng sau vài lần hỏi.
Trong danh sách 21 xu hướng AI do Greg Isenberg tổng hợp (Hồ Quốc Tuấn giới thiệu bằng tiếng Việt ngày 18/10/2026), hai nhận định liên quan trực tiếp: dữ liệu về những lần AI làm sai trong doanh nghiệp rất khan hiếm và có giá trị, và người biết đánh giá đầu ra của AI sẽ được săn đón. Bộ câu hỏi kiểm tra chính là cách doanh nghiệp tự tạo ra loại dữ liệu đó. Bài này trình bày bộ câu hỏi gồm những gì, năm nhóm câu nên có, cách chấm, ví dụ minh họa và quy trình xây từng bước.
Vì sao trợ lý AI cần bộ câu hỏi kiểm tra?
Trợ lý AI trên dữ liệu doanh nghiệp có nhiều chỗ có thể sai: dữ liệu gốc chưa sạch, công cụ đọc dữ liệu trả về thiếu, mô hình chọn nhầm công cụ, hoặc hiểu sai kỳ thời gian trong câu hỏi. Lỗi lại không cố định: đổi sang mô hình mới, thêm một công cụ, sửa một danh mục là câu trả lời có thể đổi theo.
Các nhà cung cấp lớn đều coi việc đánh giá là bước bắt buộc. Hướng dẫn của Anthropic khuyên xác định tiêu chí thành công đo được trước, rồi xây bộ câu hỏi bám đúng phân bố câu hỏi thật, có cả tình huống biên. Microsoft Learn mô tả việc chạy ứng dụng AI trên một bộ dữ liệu kiểm tra và chấm theo các tiêu chí như mức có căn cứ (groundedness) và mức đúng trọng tâm (relevance). SAP có hướng dẫn đánh giá mức có căn cứ cho ứng dụng AI đọc dữ liệu doanh nghiệp trên nền tảng AI Core. Điểm chung: đo bằng bộ câu hỏi cố định, chạy lại được, không đo bằng ấn tượng.
Bộ câu hỏi kiểm tra gồm những gì?
Mỗi câu trong bộ là một dòng có đủ thông tin để chấm lại bất cứ lúc nào:
| Thành phần | Ý nghĩa | Ví dụ |
|---|---|---|
| Câu hỏi | Viết đúng như người dùng hay hỏi, kể cả cách nói tắt | "Tuần này còn bao nhiêu đơn chưa giao?" |
| Vai trò người hỏi | Hỏi dưới quyền của ai | Trưởng phòng kế hoạch, nhân viên kho |
| Đáp án đúng | Con số hoặc kết luận, chốt tại một thời điểm | 7 đơn, tính đến 17:00 ngày chốt dữ liệu |
| Nguồn đáp án | Chứng từ, báo cáo dùng để đối chiếu | Danh sách đơn hàng lọc theo ngày giao |
| Nhóm câu | Một trong năm nhóm ở mục dưới | Tra cứu một con số |
| Cách chấm | So số tự động, người chấm hoặc mô hình chấm | So số, sai lệch cho phép bằng 0 |
Đáp án phải gắn với thời điểm chốt dữ liệu, nếu không thì hôm sau số liệu đổi và cả bộ câu hỏi mất giá trị. Cách làm đơn giản nhất là chạy kiểm tra trên một bản sao dữ liệu cố định.
Năm nhóm câu hỏi nên có
- Tra cứu một con số: tồn kho một mã hàng, số đơn chưa giao, doanh thu một tháng. Dễ chấm tự động.
- Tổng hợp và so sánh: khách nào mua nhiều nhất quý này, công đoạn nào trễ nhiều nhất tuần qua. Kiểm tra khả năng gộp đúng và xếp hạng đúng.
- Truy vết qua nhiều chứng từ: đơn bán này đã lên lệnh sản xuất chưa, giao được bao nhiêu, còn kẹt ở công đoạn nào. Kiểm tra việc gọi đúng chuỗi công cụ.
- Câu vượt quyền: nhân viên kho hỏi giá vốn, nhân viên bán hàng hỏi lương. Đáp án đúng là từ chối hoặc chỉ trả phần được phép.
- Câu không có dữ liệu: hỏi về kỳ chưa phát sinh, mã hàng không tồn tại. Đáp án đúng là nói không có dữ liệu, không được tự đoán.
Hai nhóm cuối hay bị bỏ quên, nhưng lại là nơi rủi ro nhất: trợ lý trả lời trôi chảy một câu đáng lẽ phải từ chối.
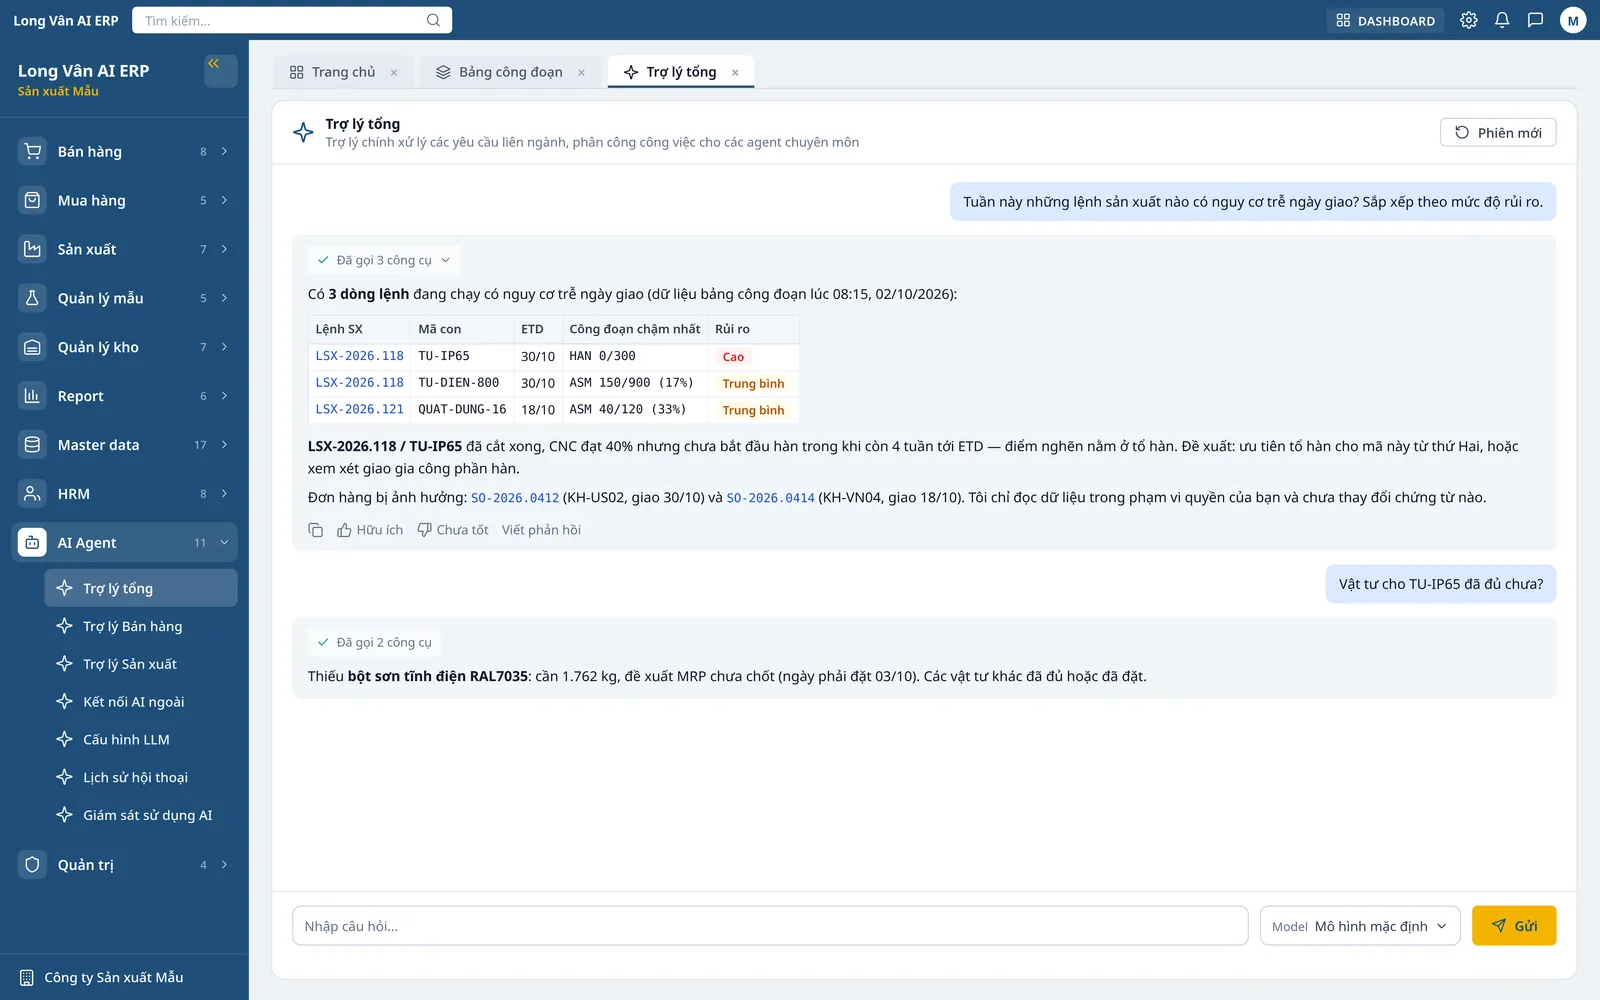
Chấm điểm câu trả lời theo bốn tiêu chí
- Đúng con số: so với đáp án đã chốt. Câu có đáp án là số thì chấm bằng so sánh tự động.
- Có căn cứ: câu trả lời dựa trên dữ liệu công cụ trả về, không thêm thông tin ngoài.
- Đúng phạm vi quyền: không lộ dữ liệu ngoài quyền của vai trò người hỏi.
- Đúng trọng tâm: trả lời đúng điều được hỏi, đúng kỳ thời gian, không lan man.
Về cách chấm, hướng dẫn của Anthropic xếp chấm bằng mã (so khớp, so số) là nhanh và chắc nhất, chấm bằng người linh hoạt nhưng tốn công, còn chấm bằng mô hình AI thì linh hoạt và mở rộng được nhưng phải kiểm tra độ tin cậy trước. Với dữ liệu quản trị, phần lớn câu có đáp án là con số, nên phần lớn chấm tự động được; người chỉ cần xem các câu vượt quyền và câu trả lời dạng giải thích.
Ví dụ minh họa: bộ 40 câu cho một nhà máy cơ khí
Ví dụ minh họa: một nhà máy cơ khí xây bộ 40 câu từ câu hỏi thật của phòng kế hoạch, kho, mua hàng và ban giám đốc, gồm 12 câu tra cứu, 10 câu tổng hợp, 8 câu truy vết, 5 câu vượt quyền và 5 câu không có dữ liệu (12 + 10 + 8 + 5 + 5 = 40).
- Lần chạy đầu: 31 trên 40 câu đạt, tức 77,5%. Trong 9 câu trượt có 5 câu lệch đơn vị tính (thép tấm ghi theo kg ở kho, theo tấm ở mua hàng), 2 câu hiểu "tuần này" thành 7 ngày gần nhất, 2 câu không có dữ liệu mà trợ lý vẫn đưa ra con số.
- Sửa đúng chỗ: chuẩn hóa đơn vị tính cho nhóm thép tấm, ghi rõ trong mô tả công cụ cách tính "tuần này" (từ thứ Hai), sửa công cụ để trả về thông báo rõ khi không có bản ghi.
- Lần chạy lại: 37 trên 40 câu đạt, tức 92,5%. Ba câu còn lại được ghi vào danh sách theo dõi.
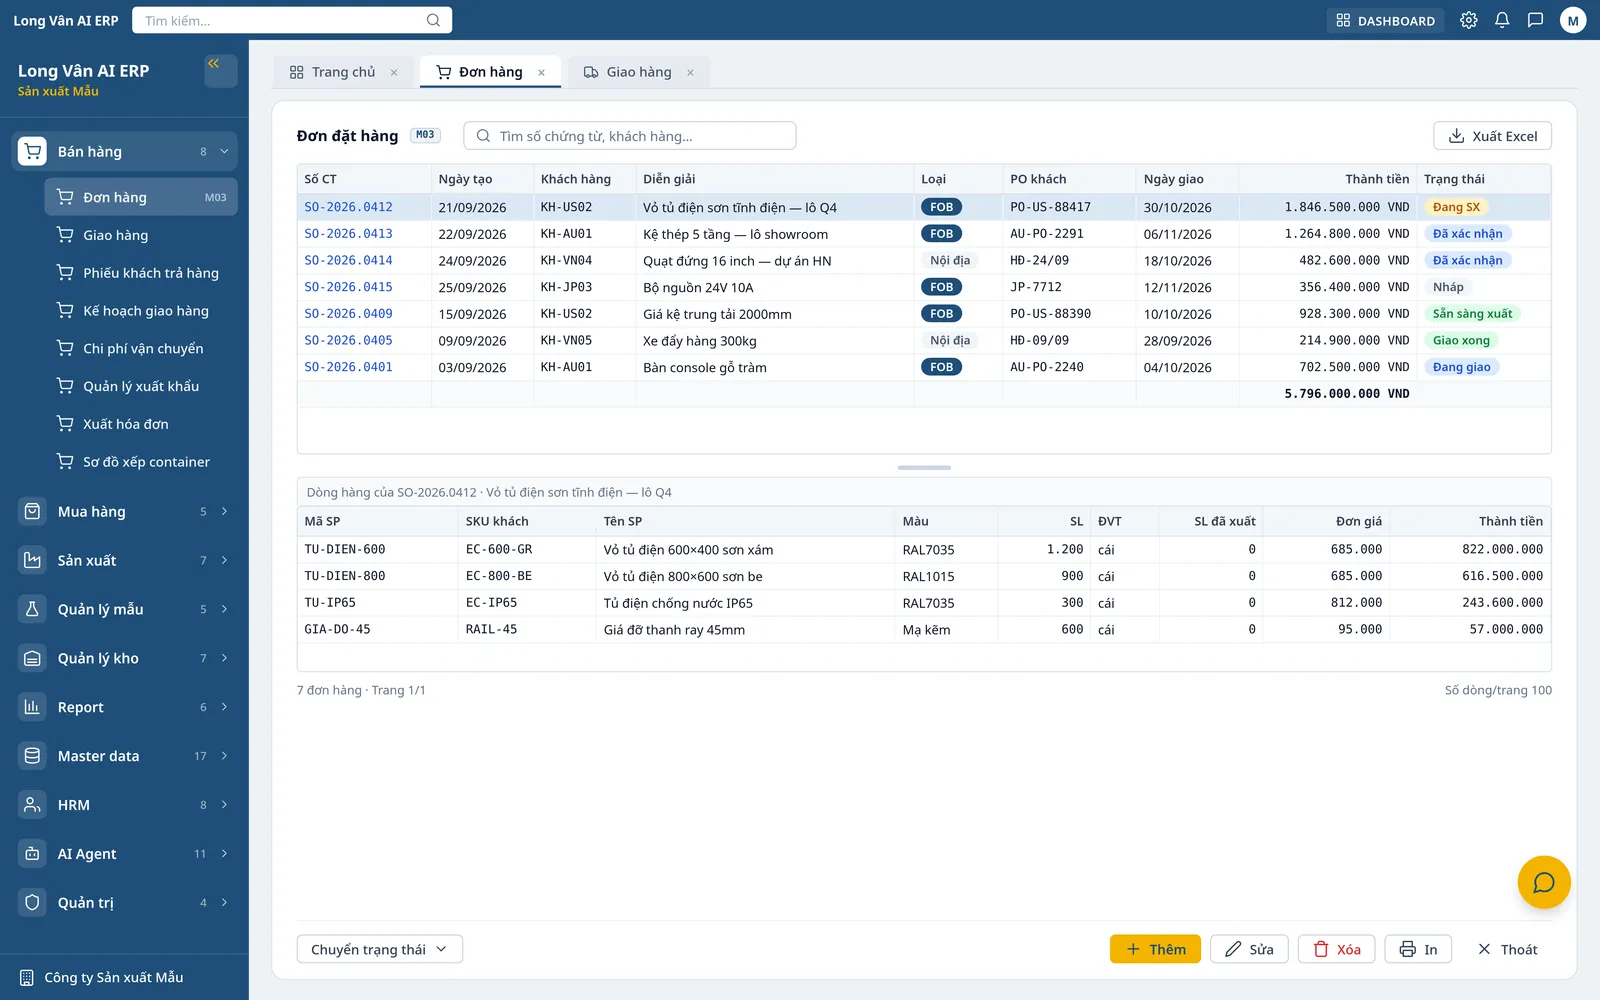
Lỗi nhiều nhất không nằm ở mô hình mà ở dữ liệu và mô tả công cụ. Đó là lý do nên làm chuẩn hóa dữ liệu doanh nghiệp trước, rồi mới mở rộng trợ lý AI. Cách làm y hệt với một xưởng may (câu hỏi về vải, phụ liệu, tiến độ đơn xuất khẩu) hay một nhà máy thực phẩm (câu hỏi về lô nguyên liệu, hạn dùng).
Quy trình xây bộ câu hỏi kiểm tra từng bước
- Thu câu hỏi thật: xin mỗi phòng ban 10 câu hay hỏi nhất, giữ nguyên cách nói.
- Chia nhóm và bổ sung: xếp vào năm nhóm, tự thêm câu vượt quyền và câu không có dữ liệu.
- Chốt dữ liệu và đáp án: chọn thời điểm chốt, lấy đáp án từ chứng từ, ghi nguồn đối chiếu.
- Gắn vai trò người hỏi: mỗi câu chạy dưới quyền của một vai trò cụ thể.
- Chọn cách chấm: so số tự động cho câu có con số; người xem câu vượt quyền và câu giải thích.
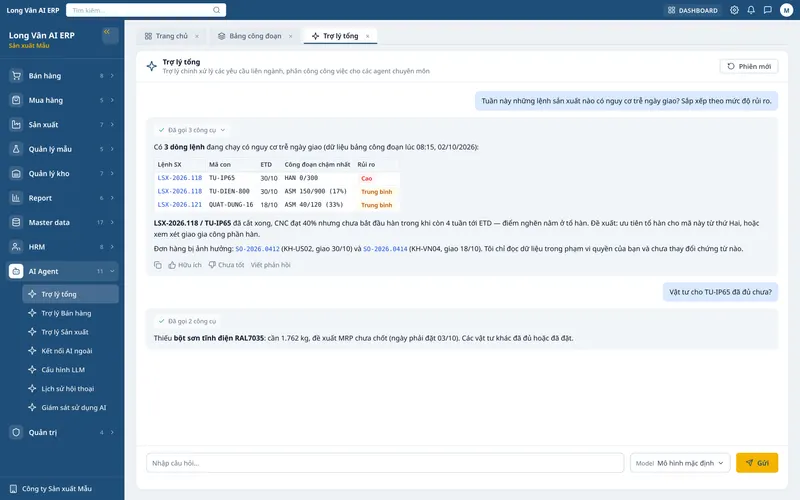
- Chạy, đọc nhật ký: xem trợ lý đã gọi công cụ nào, nhận về gì, để biết sai ở dữ liệu, công cụ hay mô hình.
- Chạy lại khi có thay đổi: đổi mô hình, thêm công cụ, sửa danh mục, đổi phân quyền đều phải chạy lại và so điểm từng nhóm với lần trước.
Lỗi thường gặp khi kiểm tra trợ lý AI
- Chỉ hỏi thử vài câu dễ: trợ lý đạt hết, rồi sai ngay ở câu thật đầu tiên của người dùng.
- Không có câu vượt quyền: không biết trợ lý có lộ dữ liệu ngoài phạm vi hay không cho tới khi đã lộ.
- Đáp án không gắn thời điểm: dữ liệu đổi mỗi ngày nên không thể so sánh giữa các lần chạy.
- Đổi mô hình mà không chạy lại: điểm có thể tăng ở nhóm này nhưng tụt ở nhóm khác.
- Đổ hết lỗi cho mô hình: phần lớn lỗi nằm ở dữ liệu gốc và mô tả công cụ; xem nhật ký gọi công cụ trước khi kết luận. Cách công cụ dữ liệu vận hành được giải thích ở bài MCP là gì.
Long Vân AI ERP hỗ trợ kiểm tra trợ lý AI thế nào?
Trong Long Vân AI ERP, các tính năng có sẵn giúp chạy và đọc kết quả kiểm tra:
- AI Agent đọc dữ liệu qua công cụ có kiểm soát: mọi con số lấy từ công cụ đọc dữ liệu, agent không tự viết SQL; phân quyền đặt ở hạ tầng nên câu vượt quyền được chặn theo đúng vai trò người hỏi.
- Nhật ký từng lần gọi công cụ: biết trợ lý đã gọi công cụ nào cho mỗi câu, để khoanh lỗi ở dữ liệu, công cụ hay mô hình.
- Nút đánh giá câu trả lời trên màn hình trợ lý: người dùng đánh dấu câu trả lời chưa đúng, thành nguồn câu hỏi mới cho bộ kiểm tra.
- Chọn mô hình: Anthropic, OpenAI, Gemini, OpenRouter hoặc endpoint tương thích, nên có thể chạy cùng bộ câu hỏi trên nhiều mô hình để so sánh.
Bộ câu hỏi kiểm tra cũng là một bước trong dịch vụ chuẩn hóa dữ liệu và kết nối AI của Long Vân AI: kết nối trợ lý AI xong, kiểm tra bằng bộ câu hỏi thật của doanh nghiệp và so câu trả lời với chứng từ. Đọc thêm cách đặt phân quyền ở hạ tầng trong bài AI Agent trong ERP.
Câu hỏi thường gặp
Bộ câu hỏi kiểm tra trợ lý AI cần bao nhiêu câu?
Không có con số chuẩn. Bắt đầu từ 30 đến 50 câu lấy từ câu hỏi thật mà các phòng ban hay hỏi là đủ để thấy lỗi lặp lại. Quan trọng hơn số lượng là độ phủ: mỗi phòng ban, mỗi nhóm câu và mỗi vai trò người dùng đều phải có câu đại diện.
Có nên để AI tự chấm câu trả lời của AI không?
Được, với câu trả lời dạng văn bản khó so khớp, nhưng phải kiểm tra trước xem mô hình chấm có chấm giống người hay không. Câu có đáp án là con số nên chấm bằng so sánh tự động, vì nhanh và chắc chắn hơn. Câu nhạy cảm như vượt quyền nên có người xem lại.
Đổi sang mô hình AI mới hơn có cần kiểm tra lại không?
Có. Mô hình mới có thể trả lời tốt hơn ở câu này nhưng kém hơn ở câu khác, hoặc gọi công cụ theo cách khác. Chạy lại cả bộ câu hỏi, so điểm từng nhóm với lần trước, rồi mới chuyển người dùng sang mô hình mới.
Trợ lý AI trả lời sai thì lỗi thường nằm ở đâu?
Thường không nằm ở mô hình. Hay gặp nhất là dữ liệu gốc chưa chuẩn (mã trùng, lệch đơn vị), công cụ trả về thiếu trường, mô tả công cụ chưa rõ khiến mô hình chọn sai công cụ, hoặc câu hỏi mơ hồ về kỳ thời gian. Bộ câu hỏi kiểm tra giúp khoanh đúng chỗ.
Đội ngũ xây dựng và triển khai Long Vân AI ERP cho doanh nghiệp sản xuất tại Việt Nam — cơ khí, điện – điện tử, may mặc, đồ gỗ, thực phẩm, bao bì — từ đơn hàng, MRP, lệnh sản xuất tới kiểm soát giá thành và AI Agent.